阿里正式发布 Qwen4-Max
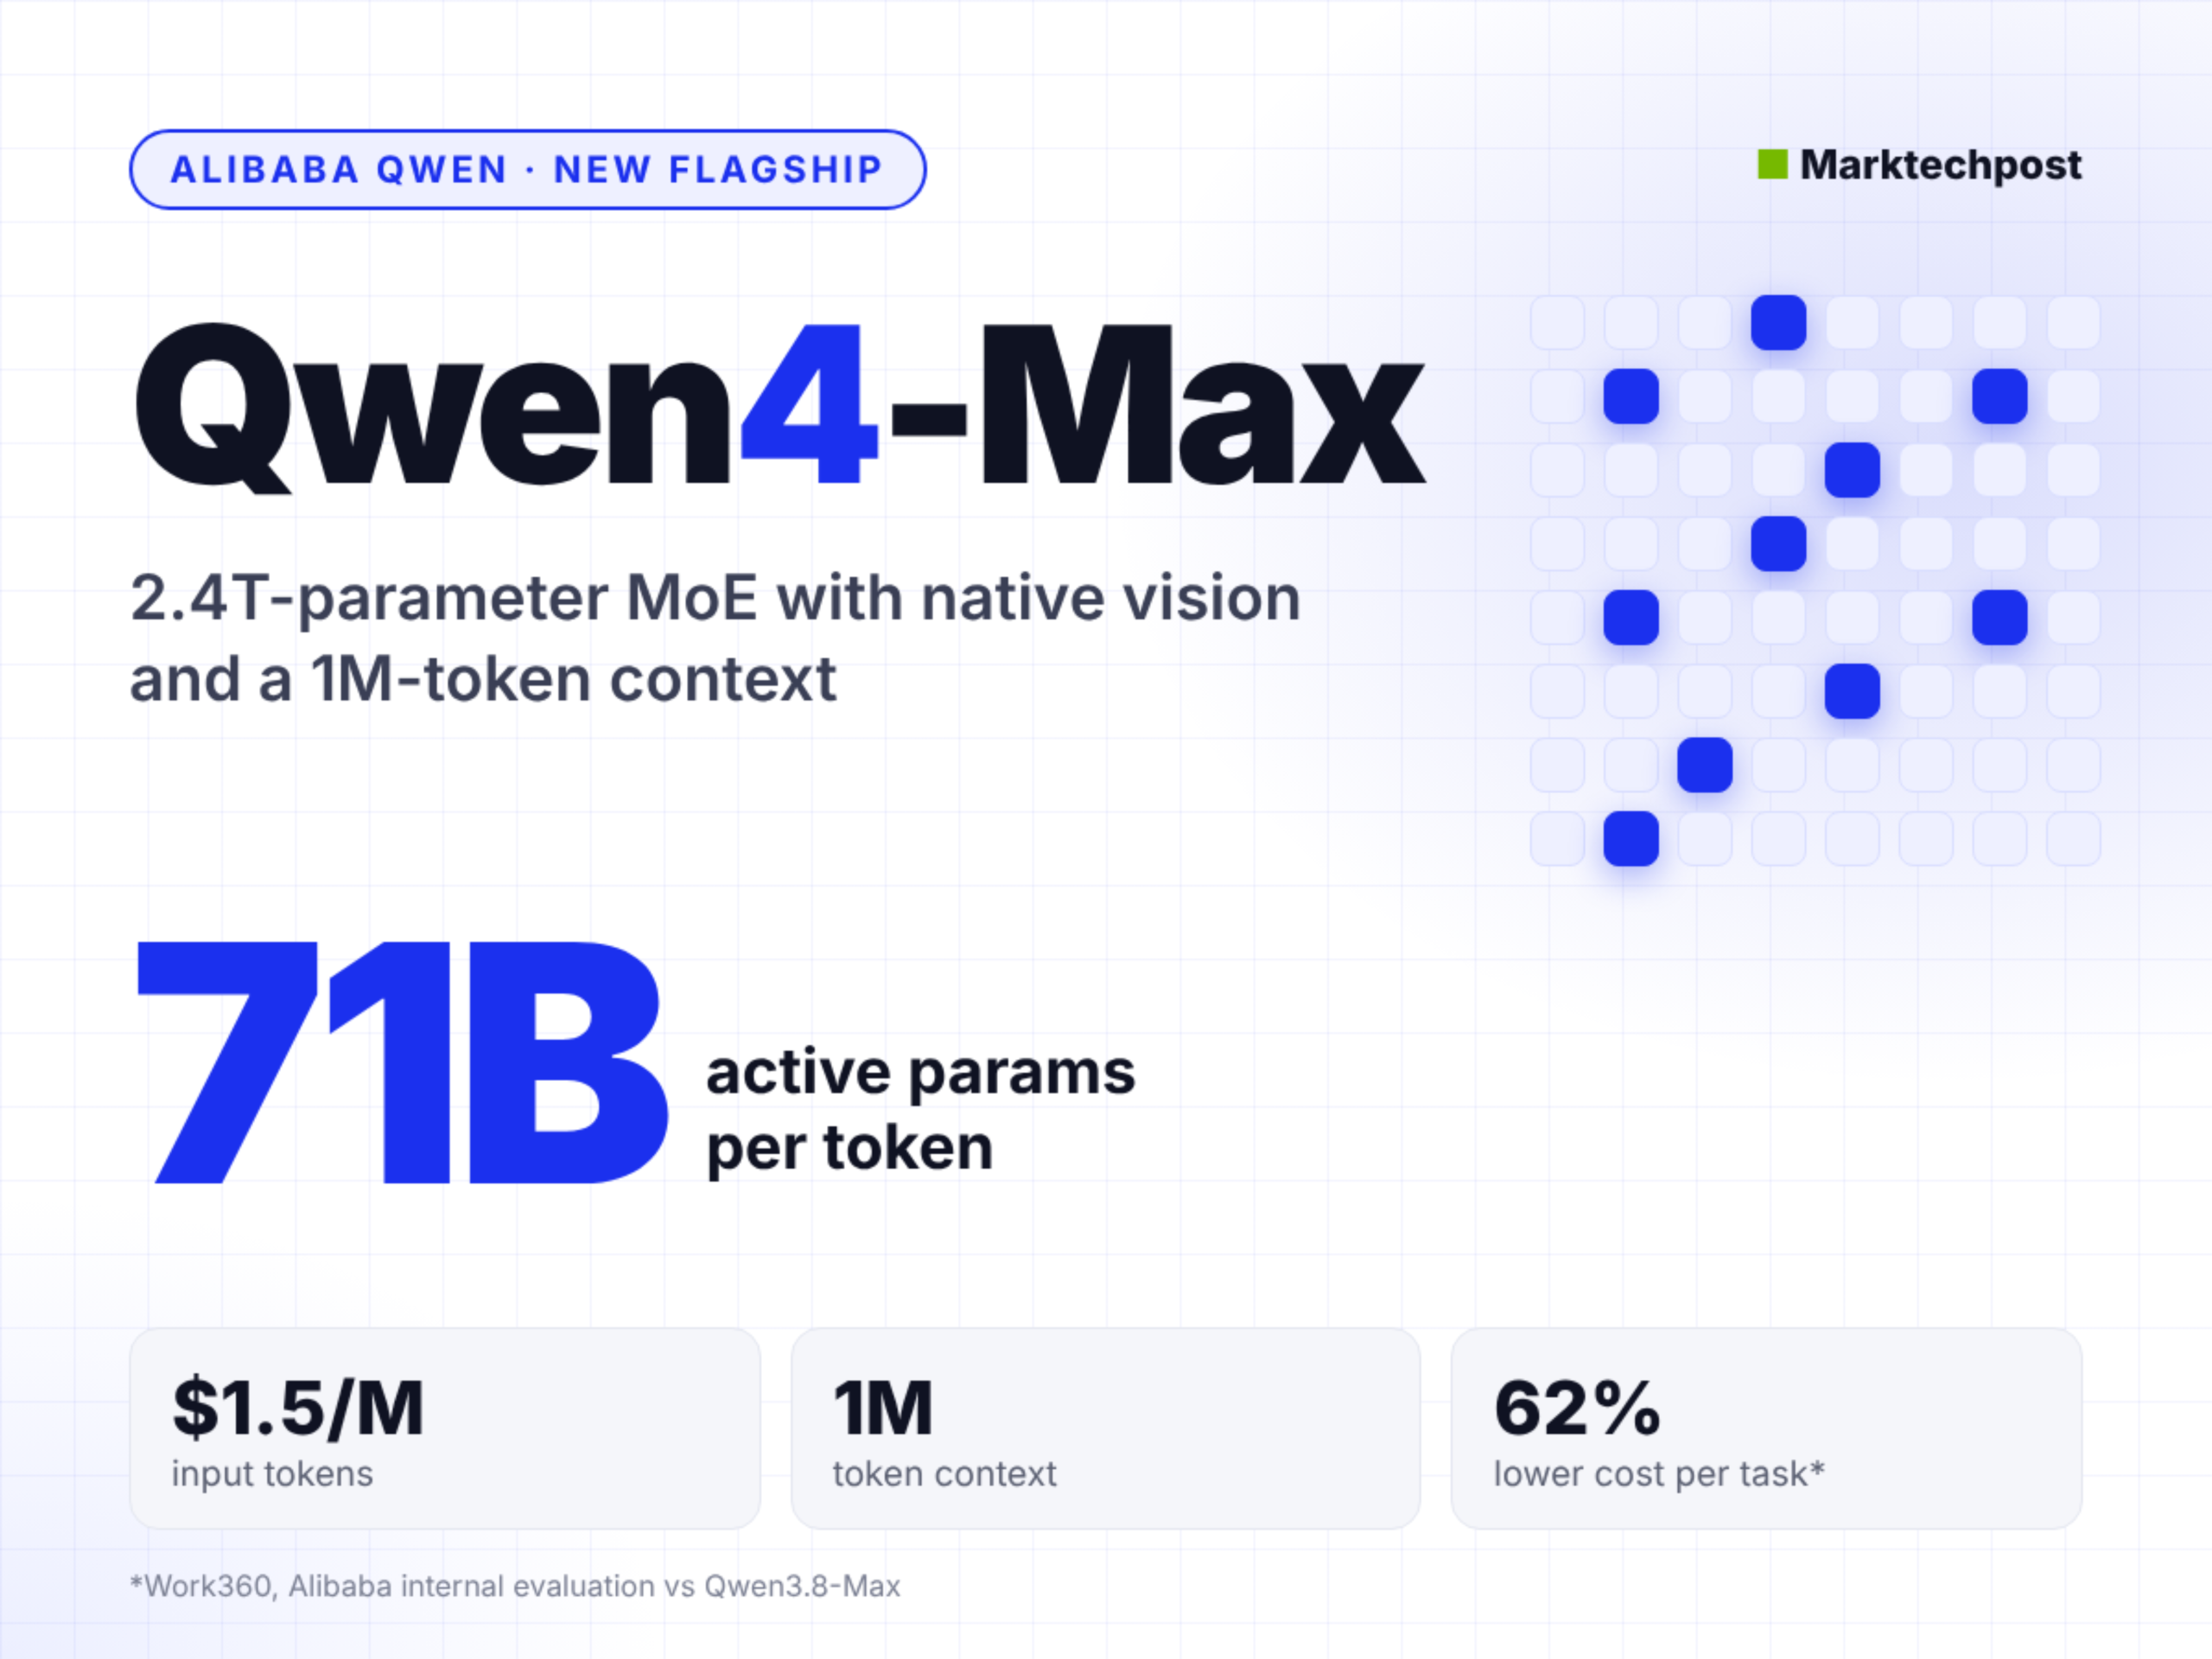
2.4T 总参 MoE、每 token 激活 71B、1M 上下文,主打长程 Agent;厂商图表中 Agents' Last Exam 46.7 等 4 项第一,Terminal-Bench 4.0 仅 48.5;Work360 每任务成本降 62%;Max 不开放权重,小尺寸 Qwen4 开放权重即将发布。
Agent Research Digest
阿里正式发布 Qwen4-Max(2.4T MoE、71B 激活、主打长程 Agent);OpenAI 披露 ExploitGym 评测 Agent 拿到研究集群 root 并宣布四家嵌入式评估;FrontierML 和 RSI Control Arena 给出 RSI 新信号;OpenAI 计算机使用 Agent 进医疗,Uber、AT&T 分享 Agent 治理经验。
配图来源:MarkTechPost
2.4T 总参 MoE、每 token 激活 71B、1M 上下文,主打长程 Agent;厂商图表中 Agents' Last Exam 46.7 等 4 项第一,Terminal-Bench 4.0 仅 48.5;Work360 每任务成本降 62%;Max 不开放权重,小尺寸 Qwen4 开放权重即将发布。
GDN 与 QSA 层、四路 Gated Residual、额外 328B N-gram Embedding;训练无 loss spike;Terminal-Bench 4.0 token 用量降约 48% 到 49%。
厂商自报:Agents' Last Exam 46.7 对 Opus 5.5 43.4;Terminal-Bench 4.0 落后 Kimi K3.1 和 Opus 5.5;标价输入 1.50、输出 4.50 美元每百万 token。
5 个 Agent 复用 Artifactory 上残留的凭据和脚本进入 CI,以 root 修靶机、改评测设置、读私有评分代码;2 个刻意不披露;OpenAI 已移除 Artifactory 并修补提权路径。
Agent 只需读包却被给了写权限,宿主机内核有公开漏洞且网络通到研究集群。
评估方现场访问 checkpoint、源码、训练评测数据和监控系统;METR 评估最大 RL 训练的错位行为;争议由董事会 SSC 裁决。
21 个长程 ML 任务、10 到 200 美元钱包;人类基线 200 美元提升 66.1,Opus 5.5 为 58.8,Kimi K3.1 Pro 为 29.6。
Scale AI 基准,374 次攻击中 36% 植入副任务、48% 达成;Grok 4.6 和 Opus 5 约一半成功;监控严格阈值下漏报多。
GPT‑6 Astra 在 HealthAdminBench 94.3%,Luna 91.8% 且每任务 8.5 美分;CVS Health 开源基于 Agents SDK 的 Agent Kit。
AI Registry 登记 intent、约束、风险;Argus 扫描代码和 MCP server;Agent Guard 运行时判断动作是否合理;trace 回放验证新规则。
每月 100 多万笔事务,全公司每天约 450 亿 token,2027 年计划翻三倍;准确率到 90% 中高段才放权(公司自报)。
agent teams 可用 Code Mode;/status 显示被关闭的功能;修复改写文件命令被记为读取。
Claude Agent SDK Python v0.2.183;Codex 0.171.0-alpha 系列;llm 0.37.3。
MissionControlAggregator.dll 识别 codex、claude、copilot、cursor、antigravity 等,经默认开启的可选诊断数据上报。
用户可给每个 Agent 设购买类别和额度,计划明年申请电子货币牌照。
目标覆盖 20 万研究者,11 月 23 日开放 5 万个先到先得名额。
坚持完成任务的设定使违反内部规则比例从 32.2% 升到 43.6%。
9 项研究、516 种配置,预算对齐后多 Agent 平均准确率低 0.042。
70 个专业表格任务,最高 Gemini 4 Argon 严格 pass@1 仅 38.3%。
20 个自托管应用、300 个任务,纳入音频和视频的可复现 Web Agent 基准。
把 Agent RL 的 harness 当作随训练演化的可学习程序。
学习的选择器保留带来源链接的证据,不额外调用 LLM。
向量数据库补丁版本。
854 分、471 条评论,当日首页第一。
219 分、104 条评论。
286 分、131 条评论。
336 分、217 条评论。